Entreprise et datacenter
Récupération de très grands volumes
Pools ZFS, grands volumes NAS et SAN, et systèmes de fichiers de centaines de téraoctets. Avec un logiciel propre qui divise la récupération en trois processus.
Récupération
Disque dur et SSD HDD, SSD, disques externes, cartes flash RAID, NAS & SAN Tous niveaux, tous contrôleurs, virtualisation Smartphones et tablettes iPhone, Android, iPad, Huawei Bandes LTO, DAT, DLT et formats plus anciensEntreprise et datacenter
Très grands volumesUnique Three-Tier Recovery, ZFS, centaines de To Récupération multicouche Virtualisation, dédup, bases de données Récupération sur site Chez vous, salle blanche mobile Sauvegardes inaccessibles Veeam, Backup Exec, Macrium ReflectSpécialisé
Destruction de donnéesGratuit Selon RGPD et ISO 27001 Analyse forensique Investigation numérique Récupération exclusiveExclusive Chez vous, sous vos yeux Zones de conflit Zones de crise et de guerre Récupération de mot de passe HDD, Word, Excel Déclarations de sinistre Documentation et certificats
Accès après connexion.
EN · RU · ZH · ES
Entreprise et datacenter
Pools ZFS, grands volumes NAS et SAN, et systèmes de fichiers de centaines de téraoctets. Avec un logiciel propre qui divise la récupération en trois processus.
Un volume de plusieurs centaines de téraoctets ne se traite pas comme un grand disque dur. Les données sont réparties sur des dizaines de disques, le système de fichiers conserve sa structure dans des arbres et des références eux-mêmes dispersés sur tout le volume, et avec des systèmes copy-on-write comme ZFS et Btrfs, plusieurs versions d'une même structure coexistent souvent.
Les logiciels de récupération ordinaires tentent de lire et de comprendre un tel volume en une seule fois. À cette échelle, ils se heurtent au temps, à la mémoire ou à la quantité de résultats intermédiaires.
Systèmes de fichiers et volumes pouvant atteindre des centaines de téraoctets, par exemple :
Vous doutez que votre système soit concerné ? Contactez-nous avec les caractéristiques de votre installation.
Nous avons donc développé notre propre logiciel, qui divise la récupération en trois processus successifs :
Nous parcourons le volume à la recherche des éléments du système de fichiers : nœuds, fragments et extraits (nodes, fragments, snippets) de métadonnées et de données, où qu'ils se trouvent.
Les éléments trouvés sont cartographiés, enchaînés, assemblés et triés (mapping, chaining, stitching, sorting), jusqu'à ce que la structure des dossiers et fichiers soit à nouveau cohérente.
Les fichiers reconstruits sont consolidés et transférés vers le stockage de destination (consolidate, transfer).
Pourquoi ainsi : en divisant la récupération en trois processus, aucun processus ne doit contenir tout le volume en une fois, et chacun fournit son propre résultat sur lequel le suivant s'appuie.
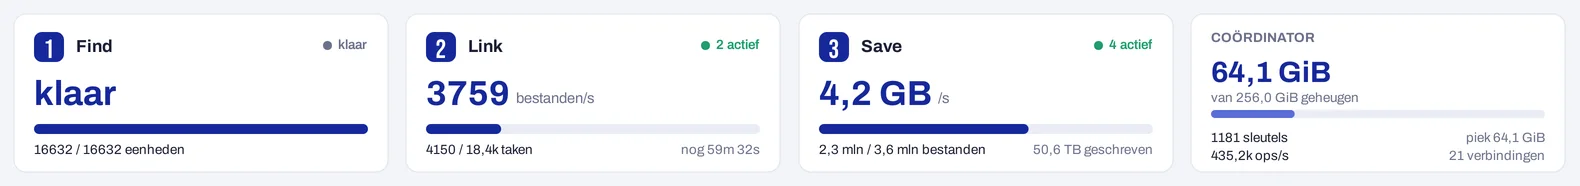
Les trois processus tournent dans notre propre logiciel, Three-Tier Recovery. Un coordinateur (coordinator) répartit le travail et conserve en mémoire les clés trouvées ; le traitement proprement dit est effectué par des workers, par processus : les workers Find analysent le volume, les workers Link relient les éléments entre eux, les workers Save enregistrent les fichiers.
Un moniteur montre à tout moment le déroulement d'un dossier :

Les paramètres de performance, comme la fenêtre d'analyse (scan window), la taille des lots, la taille de lecture maximale et le nombre de threads de liaison, peuvent être modifiés pendant une tâche en cours, et une tâche peut être mise en pause. Nous adaptons ainsi la charge à l'état des disques et aux machines disponibles.
Pour les systèmes de fichiers avec checksums, comme ZFS, le logiciel contrôle les checksums des données lues et comptabilise les blocs corrects et ceux qui ont été réparés.
Les workers ne doivent pas tourner sur une seule machine. L'analyse est répartie sur plusieurs nœuds, qui traitent chacun une partie du volume. Pour un volume de centaines de téraoctets, nous engageons autant de workers que le dossier l'exige, et les suivons séparément.

ZFS n'écrase jamais les données existantes (copy-on-write) : il écrit de nouvelles versions et y renvoie depuis un arbre de pointeurs de blocs. Au sommet se trouve toujours l'état le plus récent du pool. Si celui-ci est endommagé, par exemple par un disque défectueux, une erreur d'importation ou une coupure de courant, le pool refuse souvent de s'importer, alors que les données elles-mêmes sont toujours là.
Comme ZFS n'écrase pas immédiatement les anciennes versions de sa structure, une récupération peut souvent revenir à un état antérieur cohérent. C'est précisément ce genre de recherche que sert le premier processus.
Chaque disque d'un pool ZFS possède quatre labels : deux au début et deux à la fin. Chaque label contient un anneau d'uberblocks, et chaque uberblock renvoie à l'état du pool après un groupe de transactions (transaction group, TXG). L'état actif est l'uberblock valide portant le numéro de TXG le plus élevé.
Comme ZFS fonctionne en copy-on-write, les blocs auxquels renvoient d'anciens uberblocks restent souvent intacts pendant un certain temps. Un TXG plus ancien et cohérent peut ainsi devenir le point de départ de la reconstruction.
Autre chose que les trois processus, mais souvent dans le même dossier : des installations où les données sont empilées en plusieurs couches. Par exemple :
Si l'une de ces couches est endommagée, nous utilisons les informations des autres couches pour la reconstruire. Ainsi, le système de fichiers d'une partition révèle où celle-ci commençait et se terminait, la structure à l'intérieur d'un disque virtuel aide à remettre ses fragments dans le bon ordre, et l'organisation interne d'une base de données permet de rassembler des morceaux séparés.
Tout sur la récupération multicouche →
Partitionnement : GPT conserve une copie de secours de l'en-tête et de la table de partitions à la fin du disque. Et même sans table de partitions, le secteur de démarrage ou le superblock d'un système de fichiers révèle où commence une partition.
Déduplication (deduplication) : les données sont stockées sous forme de blocs uniques (chunks), avec un index qui détermine quels blocs forment ensemble un fichier. Si cet index est endommagé, la structure de la couche supérieure, comme un disque virtuel ou un système de fichiers, aide à réordonner les blocs.
Fichiers d'application : une base de données Exchange (ESE) se compose de pages de taille fixe, chacune avec sa propre somme de contrôle (checksum). Cela aide à les reconnaître parmi d'autres données.
Si les données ne peuvent pas quitter le bâtiment, la récupération peut aussi se faire chez vous, avec notre armoire salle blanche mobile.
Appelez-nous ou demandez une analyse, avec la configuration de votre système et ce qui s'est passé. Nous examinons avec vous la meilleure approche.
Une question sur votre disque ? Un technicien lit.