Enterprise und Rechenzentrum
Wiederherstellung sehr großer Volumes
ZFS-Pools, große NAS- und SAN-Volumes und Dateisysteme mit Hunderten Terabyte. Mit eigener Software, die die Wiederherstellung in drei Prozesse aufteilt.
Wiederherstellung
Festplatte und SSD HDD, SSD, externe Laufwerke, Flash-Karten RAID, NAS & SAN Alle Level, alle Controller, Virtualisierung Smartphones und Tablets iPhone, Android, iPad, Huawei Bänder LTO, DAT, DLT und ältere FormateEnterprise und Rechenzentrum
Sehr große VolumesEinzigartig Three-Tier Recovery, ZFS, Hunderte TB Mehrschichtige Wiederherstellung Virtualisierung, Dedup, Datenbanken Vor-Ort-Datenrettung Bei Ihnen, mobiler Reinraum Unzugängliche Backups Veeam, Backup Exec, Macrium ReflectSpezialisiert
DatenvernichtungKostenlos Nach DSGVO und ISO 27001 Forensische Untersuchung Digitale Ermittlung Exklusive DatenrettungExclusive Bei Ihnen, Sie sehen zu Krisengebiete Krisen- und Kriegsgebiete Passwort-Wiederherstellung HDD, Word, Excel Versicherungsansprüche Dokumentation und Zertifikate
Zugang nach Anmeldung.
EN · RU · ZH · ES
Enterprise und Rechenzentrum
ZFS-Pools, große NAS- und SAN-Volumes und Dateisysteme mit Hunderten Terabyte. Mit eigener Software, die die Wiederherstellung in drei Prozesse aufteilt.
Ein Volume mit Hunderten Terabyte lässt sich nicht wie eine große Festplatte behandeln. Die Daten sind über Dutzende Platten verteilt, das Dateisystem hält seine Struktur in Bäumen und Verweisen fest, die selbst über das ganze Volume verstreut sind, und bei Copy-on-Write-Systemen wie ZFS und Btrfs bestehen oft mehrere Versionen derselben Struktur nebeneinander.
Gewöhnliche Wiederherstellungssoftware versucht, ein solches Volume in einem Durchgang zu lesen und zu verstehen. In dieser Größenordnung stößt sie an Grenzen bei Zeit, Arbeitsspeicher oder der Menge an Zwischenergebnissen.
Dateisysteme und Volumes, die Hunderte Terabyte groß werden, etwa:
Sie sind unsicher, ob Ihr System dazugehört? Kontaktieren Sie uns mit den Angaben zu Ihrer Konfiguration.
Deshalb haben wir eigene Software entwickelt, die die Wiederherstellung in drei aufeinanderfolgende Prozesse aufteilt:
Wir durchsuchen das Volume nach den Bausteinen des Dateisystems: Knoten, Fragmente und Snippets (Nodes, Fragments, Snippets) von Metadaten und Daten, wo auch immer sie liegen.
Die gefundenen Teile werden kartiert, verkettet, zusammengefügt und sortiert (Mapping, Chaining, Stitching, Sorting), bis die Struktur aus Ordnern und Dateien wieder stimmt.
Die rekonstruierten Dateien werden konsolidiert und auf den Zielspeicher übertragen (Consolidate, Transfer).
Warum so: Durch die Aufteilung in drei Prozesse muss kein einzelner Prozess das ganze Volume auf einmal halten, und jeder liefert ein eigenes Ergebnis, auf dem der nächste aufbaut.
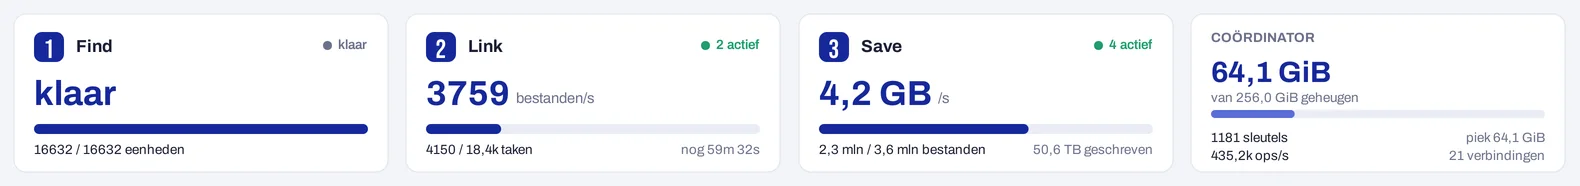
Die drei Prozesse laufen in unserer eigenen Software, Three-Tier Recovery. Ein Koordinator (Coordinator) verteilt die Arbeit und hält die gefundenen Schlüssel im Arbeitsspeicher; die eigentliche Verarbeitung übernehmen Worker, je Prozess: Find-Worker scannen das Volume, Link-Worker verknüpfen die Teile, Save-Worker schreiben die Dateien weg.
Ein Monitor zeigt jederzeit den Verlauf eines Auftrags:

Leistungsparameter wie das Scanfenster (Scan Window), die Batchgröße, die maximale Lesegröße und die Anzahl Link-Threads lassen sich während eines laufenden Jobs anpassen, und ein Job lässt sich pausieren. So stimmen wir die Last auf den Zustand der Platten und die verfügbaren Maschinen ab.
Bei Dateisystemen mit Checksummen wie ZFS prüft die Software die Checksummen der gelesenen Daten und zählt, wie viele Blöcke in Ordnung waren und wie viele repariert wurden.
Die Worker müssen nicht auf einer Maschine laufen. Das Scannen wird auf mehrere Nodes verteilt, die jeweils einen Teil des Volumes verarbeiten. Für ein Volume mit Hunderten Terabyte setzen wir so viele Worker ein, wie der Auftrag erfordert, und verfolgen jeden einzeln.

ZFS überschreibt nie bestehende Daten (Copy-on-Write), sondern schreibt neue Versionen und verweist darauf aus einem Baum von Blockzeigern. Ganz oben steht immer der neueste Zustand des Pools. Ist dieser beschädigt, etwa durch eine defekte Platte, einen Importfehler oder einen Stromausfall, verweigert der Pool oft den Import, obwohl die Daten selbst noch vorhanden sind.
Da ZFS ältere Versionen seiner Struktur nicht sofort überschreibt, kann eine Wiederherstellung oft auf einen früheren, konsistenten Zustand zurückgreifen. Genau für diese Art der Suche ist der erste Prozess da.
Jede Platte in einem ZFS-Pool hat vier Labels: zwei am Anfang und zwei am Ende. Jedes Label enthält einen Ring von Uberblocks, und jeder Uberblock verweist auf den Zustand des Pools nach einer Transaktionsgruppe (Transaction Group, TXG). Der aktive Zustand ist der gültige Uberblock mit der höchsten TXG-Nummer.
Da ZFS mit Copy-on-Write arbeitet, bleiben die Blöcke, auf die ältere Uberblocks verweisen, oft noch eine Zeit lang unberührt. Eine ältere, konsistente TXG kann so zum Ausgangspunkt der Rekonstruktion werden.
Etwas anderes als die drei Prozesse, aber oft im selben Auftrag: Konfigurationen, in denen Daten in mehreren Schichten übereinander liegen. Zum Beispiel:
Ist eine dieser Schichten beschädigt, nutzen wir die Informationen aus den anderen Schichten, um sie zu rekonstruieren. So verrät das Dateisystem in einer Partition, wo diese begann und endete, die Struktur in einem virtuellen Datenträger hilft, seine Fragmente in die richtige Reihenfolge zu bringen, und der innere Aufbau einer Datenbank ermöglicht es, einzelne Teile wieder zusammenzusetzen.
Alles über mehrschichtige Wiederherstellung →
Partitionierung: GPT speichert eine Sicherungskopie des Headers und der Partitionstabelle am Ende der Platte. Und selbst ohne Partitionstabelle verrät der Bootsektor oder Superblock eines Dateisystems, wo eine Partition beginnt.
Deduplizierung (Deduplication): Die Daten liegen als eindeutige Blöcke (Chunks) in einem Speicher, mit einem Index, der festlegt, welche Blöcke zusammen eine Datei bilden. Ist dieser Index beschädigt, hilft die Struktur der darüberliegenden Schicht, etwa eines virtuellen Datenträgers oder Dateisystems, die Blöcke neu zu ordnen.
Anwendungsdateien: Eine Exchange-Datenbank (ESE) besteht aus Seiten fester Größe, jede mit eigener Prüfsumme (Checksum). Das hilft, sie zwischen anderen Daten zu erkennen.
Dürfen die Daten das Gebäude nicht verlassen, kann die Wiederherstellung auch bei Ihnen vor Ort stattfinden, mit unserem mobilen Reinraumschrank.
Rufen Sie uns an oder fragen Sie eine Analyse an, mit dem Aufbau Ihres Systems und was passiert ist. Gemeinsam finden wir den besten Ansatz.
Fragen zu Ihrer Platte? Ein Techniker liest mit.